PVE 9超融合基础设施 - 2.配置集群实现高可用和自动平衡
Proxmox VE 集群管理器 pvecm 是一款用于创建一组物理服务器。这样的称为cluster - 集群。使用 Corosync 集群引擎来实现可靠的集群沟通。集群中没有明确的节点数量限制。 实际上,实际可能的节点数可能受主机和 网络表现。目前(2021年),有关于集群(使用 高端企业硬件)拥有超过50个节点在生产中。
PVECM可用于创建新集群,将节点连接到集群, 离开集群,获取状态信息,并做各种与集群相关的工作 任务。Proxmox cluster File System(“pmxcfs”) 用于透明地将集群配置分发到所有集群节点。
将节点分组到集群中有以下优势:
集中式、基于网络的多节点统一管理
多主集群:每个节点可以完成所有管理任务,没类似vCenter的东西,在集群内任意节点登录皆可管理所有节点。
使用 pmxcfs,一种数据库驱动的文件系统,用于存储配置 文件,通过CoroSync在所有节点上实时复制
虚拟机和容器在物理间的实时迁移和冷迁移。
集群范围的服务,如防火墙和HA
参考文档:https://pve.proxmox.com/pve-docs/chapter-pvecm.html#chapter_pvecm
Proxmox Datacenter Manager 可用于管理多集群,但目前还未完善。 https://www.proxmox.com/en/products/proxmox-datacenter-manager/overview
PVE系列文章:https://songxwn.com/categories/PVE/
集群要求
所有节点必须能够通过UDP端口5405-5412相互连接,用于让Corosync组件正常工作。
日期和时间必须同步,需要配置统一的NTP服务器
节点之间需要在TCP 22端口上建立SSH隧道。
如果你对生产环境高可用性有要求,你需要拥有至少有四个节点以确保可靠性。所有节点都应拥有同样的PVE版本。
对于较小的双节点集群,可以使用 QDevice 提供第三票。
建议为集群流量使用专用的物理网卡。
Proxmox VE 集群通信使用 Corosync 协议。
Corosync 需要稳定、低延迟的网络,但带宽需求不高。
大多数情况下,一个专用的 1 Gbit 网卡就足够了。
这样可以避免其他服务占用全部可用带宽,从而导致 Corosync 数据包延迟增加。额外的集群流量链路可以在专用网络故障时提供冗余。
Corosync 最多支持 8 条链路。
为了确保 Corosync 的可靠性,至少应在另一个物理网络上配置一条额外连接。
这样即使专用网络发生故障,Corosync 仍能保持集群通信。单一链路如果通过 bond 支撑,在某些故障场景下可能存在问题。
参见:Corosync over Bonds添加节点需要集群节点的root密码。
虚拟机的在线迁移需来自同一个供应商 AMD/Intel (最好同系列同型号)。
PVE 集群实现功能
加入集群后的 PVE 节点可以实现集中管理、虚拟机/容器的在线迁移、高可用 (HA) 故障自愈,以及统一的配置与防火墙策略。相比单机模式,集群显著提升了可扩展性、可靠性和运维效率。
PS:CT容器只能冷迁移。
加入集群后的主要功能
集中式管理
所有节点共享 Web 界面,任何节点都能管理整个集群。配置通过 pmxcfs 自动同步,避免手工维护。虚拟机/容器迁移
支持 在线迁移 (Live Migration),在不中断业务的情况下将 VM/LXC 从一台物理主机迁移到另一台,实现负载均衡与维护便利。高可用 (HA)
借助 pve-ha-manager 与 watchdog,当节点宕机时,集群会自动在其他节点上重启受影响的虚拟机,保障业务连续性。统一防火墙策略
防火墙规则可在集群范围内快速下发,保证安全策略一致。共享存储整合
配合 Ceph、NFS、iSCSI 等共享存储,迁移时只需传输内存状态,速度快且网络压力小。
集群架构关键点
| 组件 | 作用 |
|---|---|
| Corosync | 集群通信与心跳检测,保证节点状态一致 |
| pmxcfs | 分布式配置文件系统,实时同步配置 |
| votequorum | 仲裁机制,防止脑裂,保证集群一致性 |
| pve-ha-manager | 高可用资源监控与故障恢复 |
| watchdog | 节点失联时自动重启释放资源 |
风险与注意事项
- 配置覆盖风险:加入集群时,节点原有
/etc/pve配置会被覆盖,需提前备份虚拟机并重新导入。 - 节点数量要求:至少 3 节点才能保证可靠的 quorum;双节点需额外配置 QDevice。
- 硬件兼容性:在线迁移要求 CPU 厂商一致,否则可能失败。
- 网络要求:Corosync 对延迟敏感,建议使用专用 NIC,避免与存储/迁移流量混用。 virtualenvironment.cn shallowhave.github.io Proxmox VE 中文文档
在 PVE 集群中启用 HA (High Availability),需要满足一系列条件,确保故障时虚拟机能自动迁移或重启。核心条件如下:
HA 实现条件
集群节点数量
至少 3 个节点,保证 quorum 仲裁正常工作。双节点集群必须额外配置 QDevice,否则容易脑裂。共享存储
所有 HA 虚拟机必须使用共享存储(如 CephRBD、NFS、iSCSI、SMB),否则故障节点上的磁盘无法在其他节点访问。Corosync 通信稳定
集群心跳依赖 Corosync,要求低延迟、稳定网络,最好使用独立网卡或 VLAN,避免与迁移/存储流量混合。Watchdog 配置
每个节点必须启用硬件或软件 Watchdog,保证节点失联时能自动触发重启,释放资源。pve-ha-manager 服务
集群必须运行 HA 管理器,负责监控虚拟机状态并在故障时调度到其他节点。一致的 CPU 架构
在线迁移和 HA 重启要求 CPU 指令集兼容,通常需同一厂商、同一代架构。虚拟机 HA 标记
在 VM 配置中显式启用 HA,集群才会对其进行故障恢复;未启用的 VM 不会自动迁移。统一网络 - VNET
需要虚拟机在集群 - SDN创建Vnet (类似VMware的分布式交换机vDS / NSX)
额外注意事项
- 仲裁机制:必须保证多数节点在线,否则 HA 无法正常工作。
- 资源预留:集群需有足够的空闲资源,否则故障节点上的 VM 无法在其他节点启动。
- 测试验证:建议在生产前进行故障模拟,验证 HA 是否能按预期恢复。
PVE 创建集群
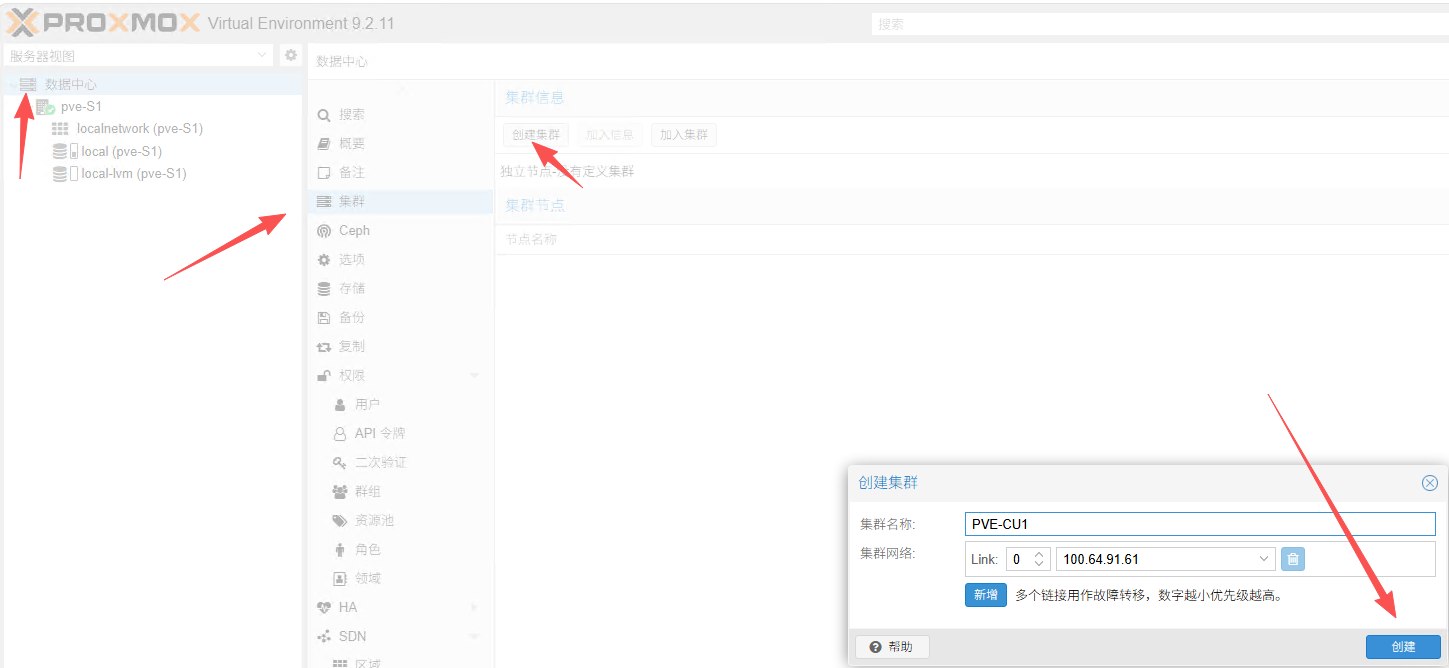
- 打开Web界面,数据中心-集群 - 创建集群 - 输入集群名字 - 选择集群通信链接
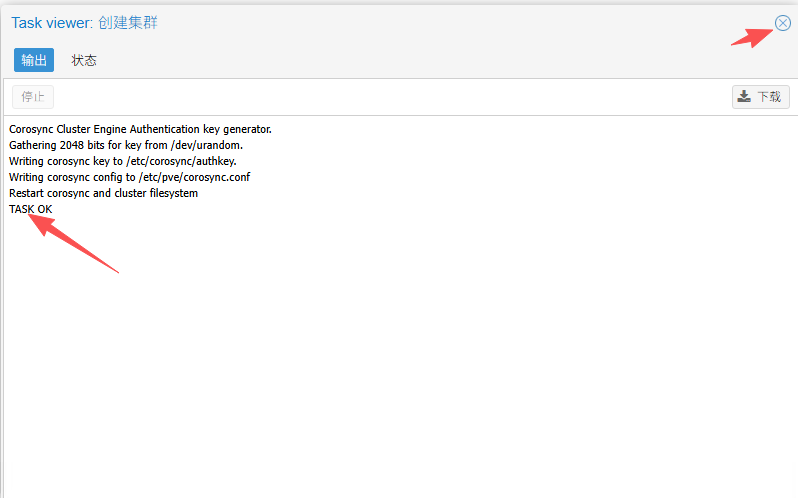
- 创建完成
在shell查看状态
1 | root@pve-S1:~# pvecm status |
加入集群
获取集群加入信息 - 在一个PVE上创建集群后复制加入信息
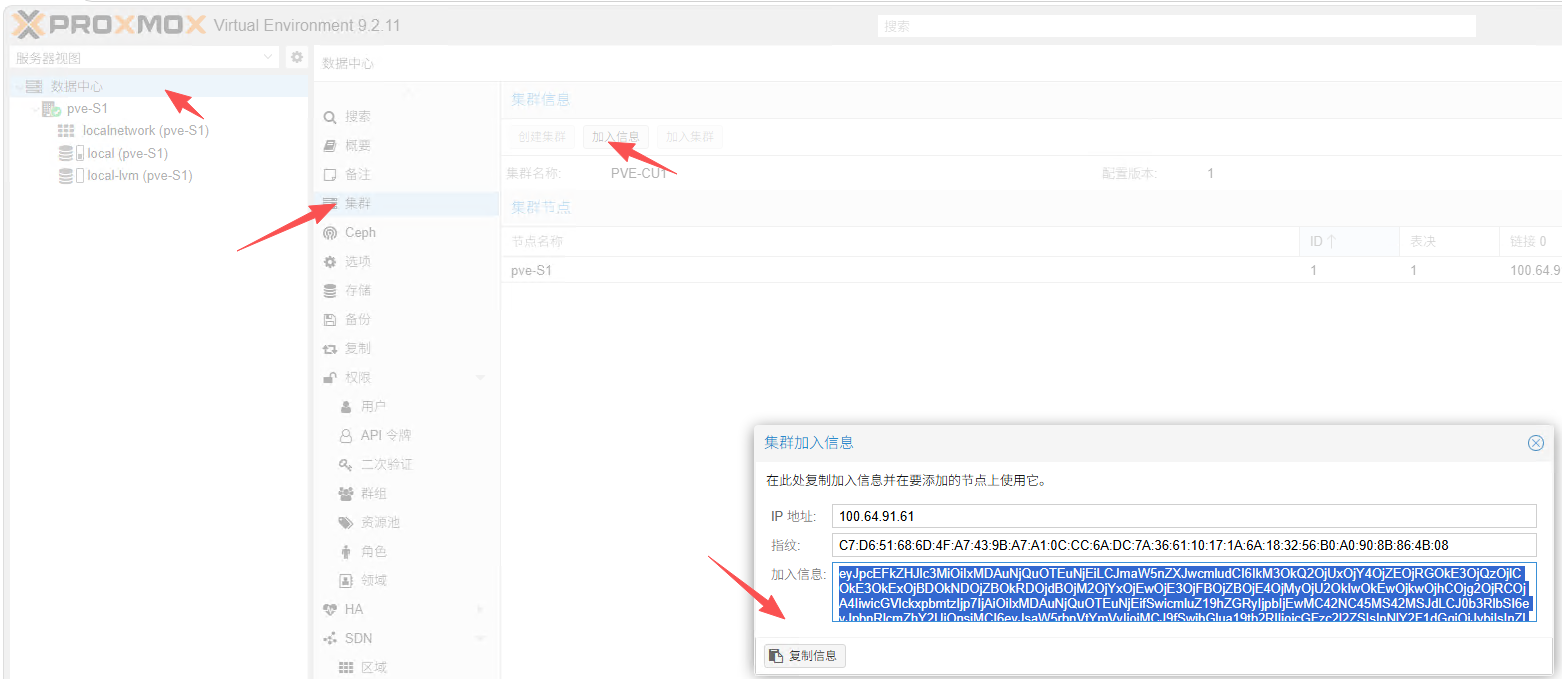
PS:注意IP地址可互相通信,这个IP地址在 /etc/hosts文件里面读取,可修改重启后再次读取。
在第二台PVE节点加入到已有集群
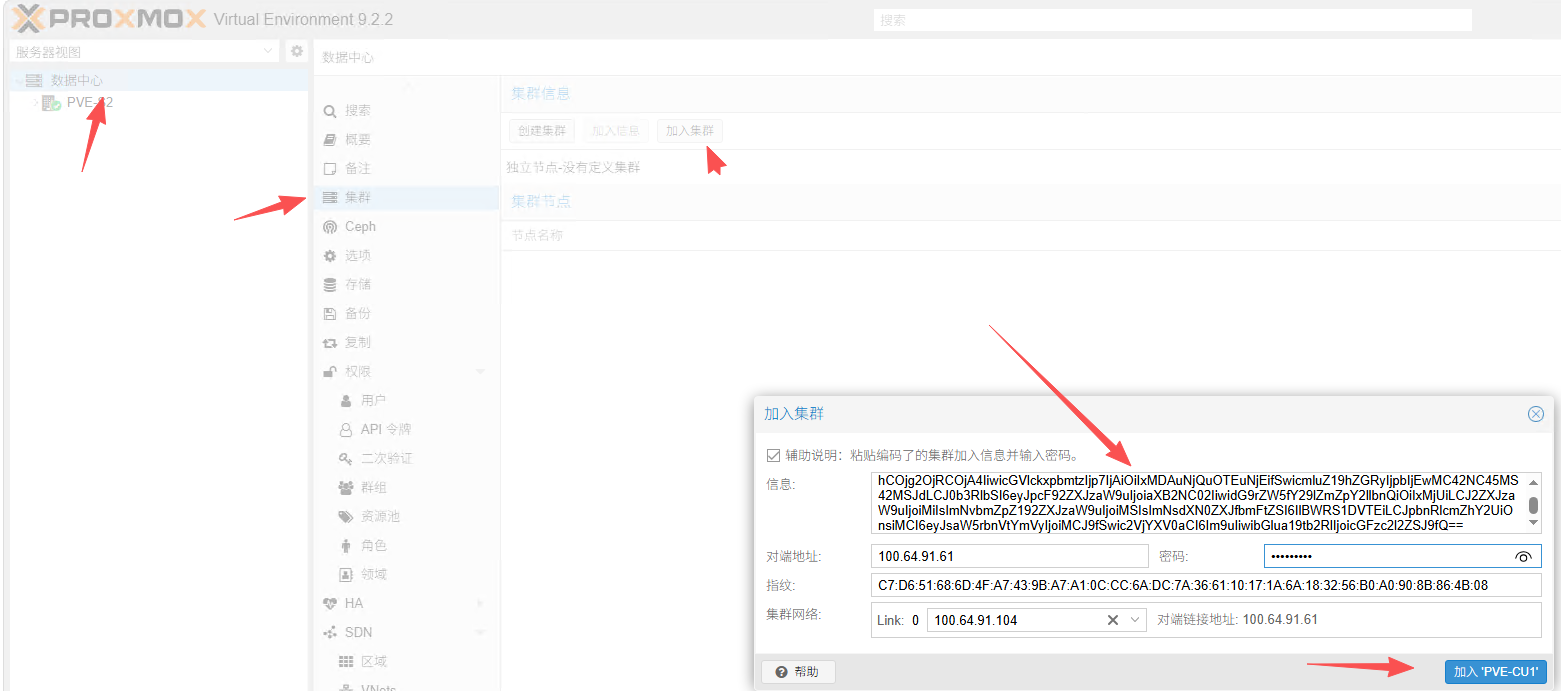
- 注意,密码是第一台创建集群的PVE root密码。
查看状态 - 在任意集群内节点登录
1 | root@PVE-S2:~# pvecm status |
PS:Ceph + HA最好使用3个以上节点才能支持。
PVE配置NTP服务器
1 | nano /etc/chrony/chrony.conf |
- 修改pool行为指定ntp服务器
重启服务和验证
1 | systemctl restart chrony |
HA 高可用 和 CRS 集群资源调度器
HA 关机策略
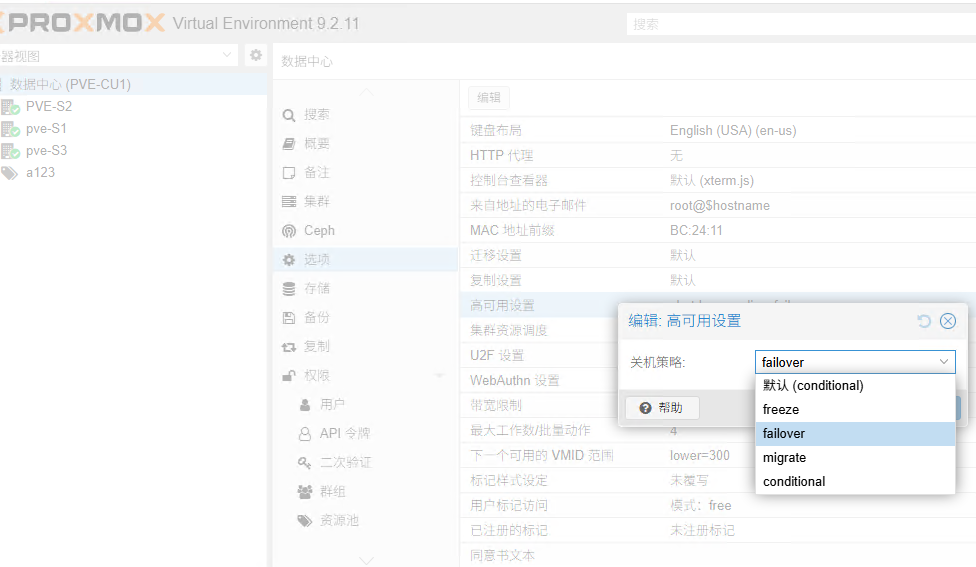
在 Proxmox VE 的 高可用设置 (HA Settings) 里,你看到的“关机策略 (Shutdown Policy)”选项,主要决定了当节点或虚拟机遇到关机/故障时,集群如何处理资源的行为。它的作用是保证服务尽可能持续运行,减少单点故障带来的影响。
各策略作用说明
默认 (conditional)
- 默认策略,通常根据具体情况决定是否迁移或关闭。
- 如果节点正常关机,资源会被安全停止(关机);如果是异常宕机,则触发迁移或故障转移到其他节点。
freeze
- VM/CT 保持冻结状态,不做迁移或重启。
- 适合需要保持数据一致性,但不希望自动恢复的场景。
failover
- 当节点关机或故障时,资源会自动在其他节点上启动。
- 常用于关键业务,确保服务不中断。
migrate
- 在节点关机前,主动将 VM/CT 迁移到其他节点。
- 适合计划性维护,保证业务连续性。
conditional
- 与默认类似,根据关机原因决定是否迁移或停止。
- 灵活性较高,适合一般场景。
总结
这些策略的核心作用是:在节点关机或故障时,决定虚拟机/容器的处理方式。
- 如果你要保证业务连续性,推荐用 failover 或 migrate。
- 如果你只需要保持状态,不自动恢复,可以用 freeze。
- 如果希望灵活处理,保持默认或 conditional 即可。
HA状态
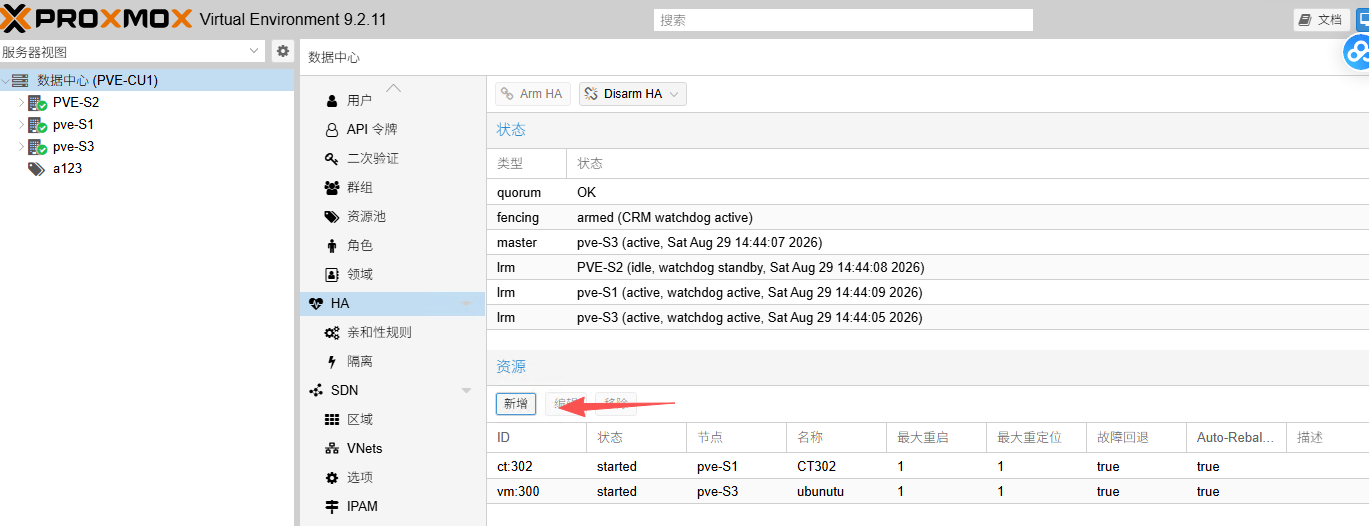
- 在资源下可以查看已加入HA保护的主机/容器,可以进行添加和移除
- 也可以关闭当前HA状态,用于维护使用。
HA 亲和性规则
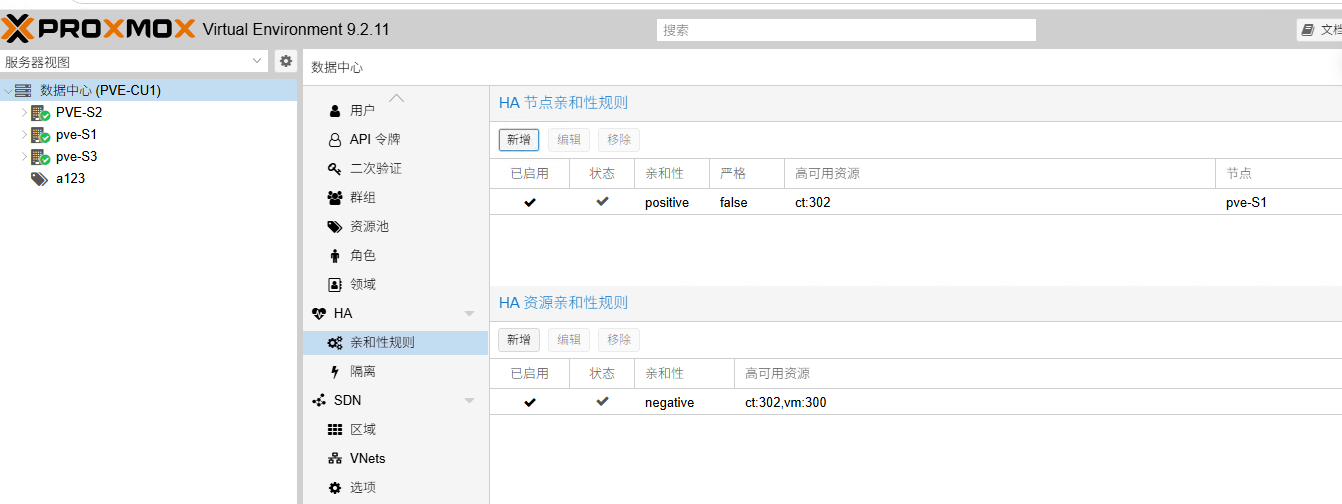
- HA节点亲和性规则:将一个或一组虚拟机/容器优先运行在一个/一组主机节点上。
- HA资源亲和性规则:配置将虚拟机/容器配置是否运行在一个节点,或者不允许在一个节点上。
停机维护
CRS
集群内三个主机节点,CPU使用率各是 10% 50% 80% 怎么办?
CRS就是解决这个的,类似VMware DRS,用于尽可能让各个节点的负载尽量均衡,更好的利用现有资源。
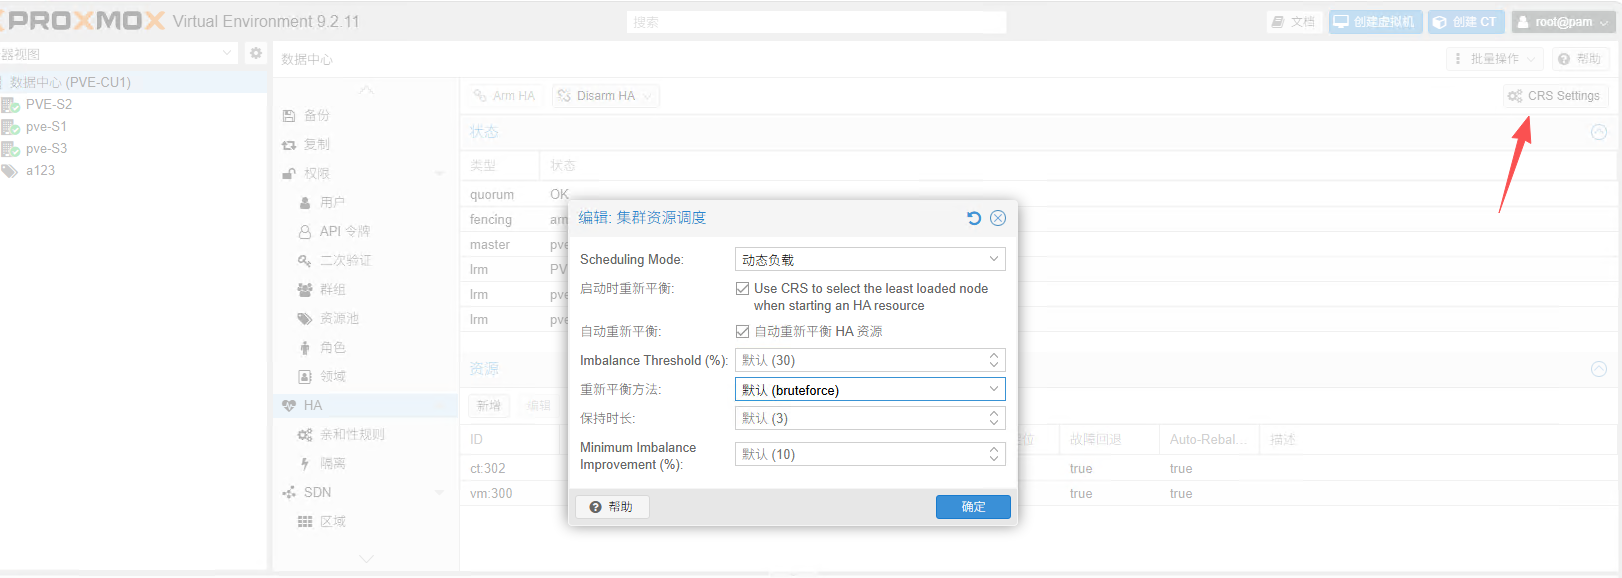
Scheduling Mode: 动态负载
- CRS 会实时监控节点负载,不仅在启动时选择最轻节点,还会在运行中动态调整。
启动时重新平衡
- 当 HA 资源启动时,自动选择负载最轻的节点,而不是固定分配。
自动重新平衡
- 集群运行过程中,如果检测到负载不均衡,自动迁移 VM/CT 到更合适的节点。
Imbalance Threshold (%)
- 默认 30%。只有当节点负载差异超过 30% 时,才会触发迁移。
重平衡方法 (bruteforce)
- 使用暴力计算方式,尝试找到最优分配方案。
保持时长
- 默认 3,表示迁移后至少等待 3 分钟才会再次触发调度,避免频繁迁移。
Minimum Imbalance Improvement (%)
- 默认 10%。只有当迁移能带来至少 10% 的负载改善时才会执行。
总结
- 启动时 → 资源分配到最轻节点。
- 运行中 → 自动监控负载,超过阈值时触发迁移。
- 迁移条件 → 必须带来明显改善,且有最小间隔时间,避免频繁波动。
自定义CPU模型
可以在集群创建自定义CPU模型,用于某些如Windows系统的性能调优。
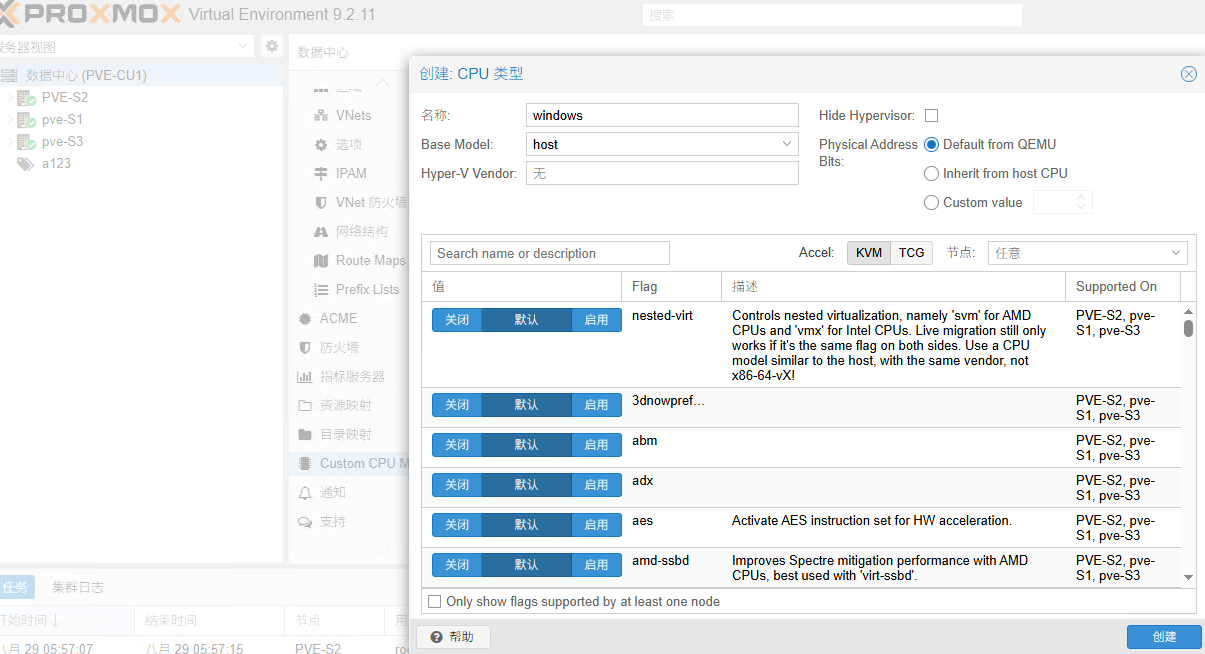
你上传的截图是 Proxmox VE 中 创建自定义 CPU 类型 的配置界面。这里涉及几个关键点,尤其是和 Windows 虚拟机兼容性、性能优化相关的参数:
核心字段说明
- Base Model: host
表示虚拟机 CPU 模型直接继承宿主机的 CPU 指令集,通常能获得最佳性能和兼容性。 - Hyper-V Vendor: 无
如果要运行 Windows Server 或 Windows 10/11,建议设置为Microsoft,这样 Windows 会识别虚拟化环境为 Hyper-V,启用更好的优化(如启用 Enlightenments)。 - Hide Hypervisor
勾选后,虚拟机内的操作系统不会检测到自己运行在虚拟化环境中。某些旧版软件或 DRM 场景可能需要隐藏,但 Windows 一般不建议启用。 - Physical Address Bits
默认即可,除非需要限制虚拟机的物理地址空间。
常见 CPU Flags
- nested-virt
控制嵌套虚拟化(Intel VMX / AMD SVM)。如果你要在虚拟机里再跑 Hyper-V 或 ESXi,需要启用。 - aes
启用 AES-NI 指令集,加速加密/解密操作(VPN、磁盘加密、TLS)。 - amd-ssbd
AMD CPU 的 Spectre 缓解优化,通常和virt-ssbd配合使用。 - adx
加速某些算术运算,主要用于高性能计算场景。 - abm
提供更高效的位操作指令。
Windows 虚拟机优化建议
- Hyper-V Vendor 设置为 Microsoft → 让 Windows 识别为 Hyper-V 环境,启用 Enlightenments。
- 启用 AES → 提升加密性能。
- 启用 nested-virt(可选)→ 如果需要在 Windows VM 内再跑 Hyper-V 或 WSL2。
- 保持 Base Model 为 host → 避免兼容性问题,尤其是 live migration 时需保证源宿主机 CPU 指令集一致。
支持存储
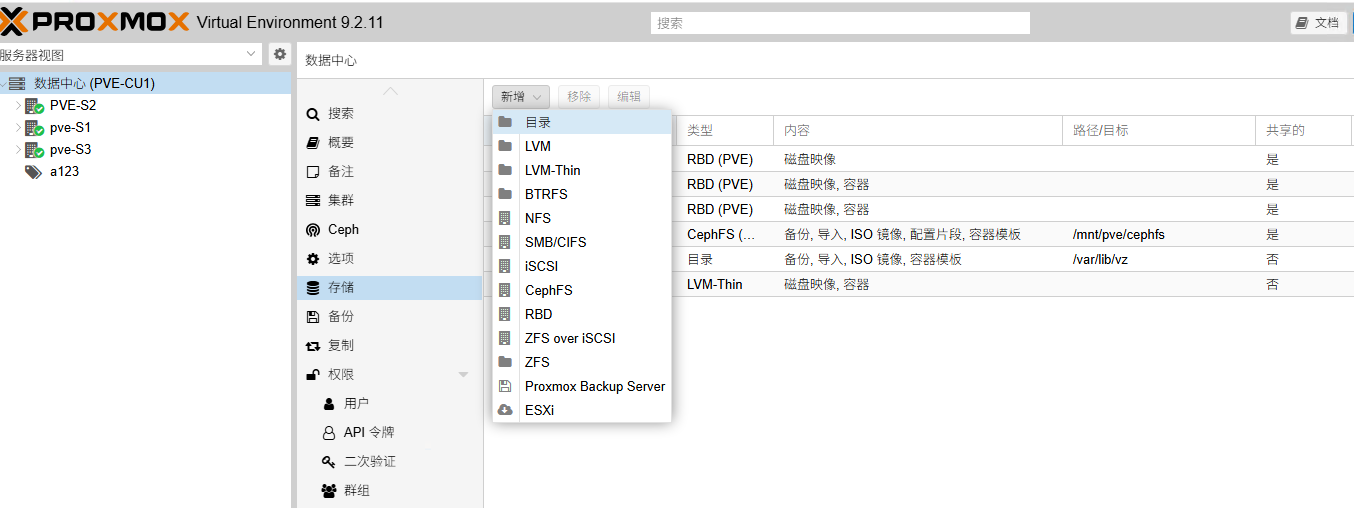
| 存储类型 | 共享 | 支持功能 |
|---|---|---|
| Ceph RBD | 是 | VM/CT 磁盘映像,分布式块存储,高可用,快照,复制 |
| CephFS | 是 | 备份、ISO、模板、配置片段,分布式文件系统 |
| ZFS | 否(本地池) | 快照、复制、压缩、完整性校验,适合高性能本地存储 |
| BTRFS | 否(本地池) | 快照、校验、轻量化存储,适合单节点或小规模 |
| LVM/LVM-Thin | 否 | VM/CT 磁盘映像,Thin 支持精简配置 |
| NFS | 是 | ISO、备份、模板共享,常用于轻量共享存储 |
| SMB/CIFS | 是 | 挂载 NAS,ISO、备份、模板共享 |
| iSCSI | 是 | 外部 SAN 块存储,适合企业环境 |
| 目录存储 | 否 | ISO、备份、模板,本地简单存储 |
| Proxmox Backup Server | 是 | 增量备份、去重、加密,专用备份后端 |
| ESXi 存储挂载 | 是 | 接入 VMware ESXi 存储资源,支持迁移与整合 |
SDN - 区域 -VNet
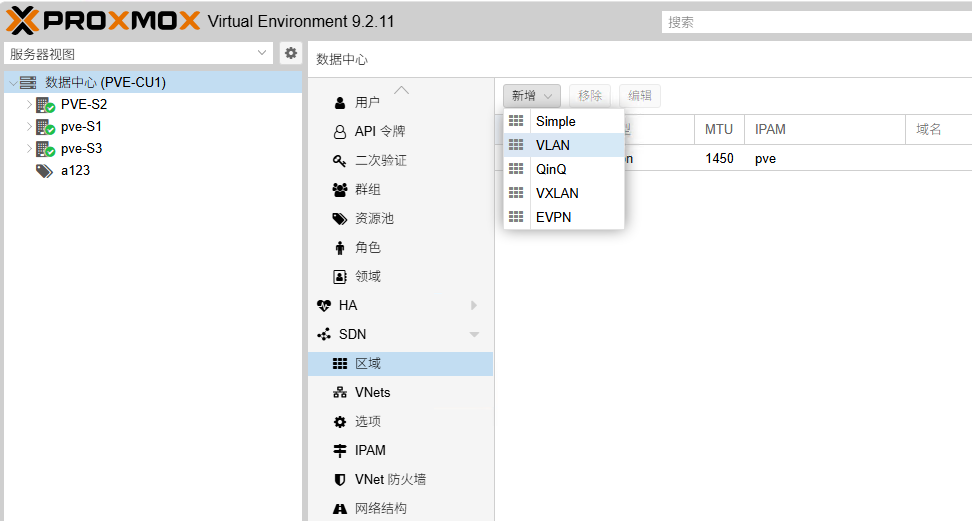
Zone 类型简析
- Simple
最基础的 Zone,不做额外封装,适合小规模或测试环境。 - VLAN
使用传统的 802.1Q VLAN 标签,常见于企业网络,简单且高效。 - QinQ
VLAN 叠加 (802.1ad),适合多租户场景,可在外层 VLAN 上再封装内层 VLAN。 - VXLAN
基于 UDP 封装的虚拟网络,常用于跨物理网络的大规模虚拟化部署。 - EVPN
结合 BGP 的控制平面,支持大规模数据中心的多租户网络,功能最强大。
Vnets
类似于VMware 的vDS的分布式端口组,是为了在集群内随意迁移到任意节点也能使用同样的网络接入。
运维技术交流群
发送邮件到 ➡️ me@songxwn.com
或者关注WX公众号:网工格物