PVE9 超融合基础设施 - 3.PVE 配置分布式共享存储Ceph
Ceph 简介
一、Ceph 核心组件在 PVE 中的角色
| 组件 | 作用 | 在 PVE 中的体现 |
|---|---|---|
| MON | 维护集群状态与一致性 | PVE 节点可安装 MON,通常部署 3 个以上,保证仲裁;在 Web 界面可查看集群健康 |
| OSD | 存储对象数据并处理读写 | 每块硬盘对应一个 OSD;在 PVE 中通过 pveceph osd create 或 Web 向导添加 |
| MGR | 提供监控与扩展模块 | PVE 默认安装 MGR,支持 Prometheus/Grafana 集成,Web 界面有 Dashboard |
| MDS | 管理 CephFS 元数据 | 在 PVE 中可选安装,用于提供共享文件系统(CephFS) |
| RGW | 提供对象存储接口 (S3/Swift) | 可在 PVE 节点上部署,提供对象存储服务 |
| RADOS | 底层分布式对象存储 | PVE 的 VM 磁盘、容器卷最终都映射到 RADOS 对象 |
| CRUSH | 数据放置算法 | PVE 中可通过 Web 界面或命令行修改 CRUSH Map,定义机架/节点分层策略 |
| RBD | 块设备接口 | PVE 的虚拟机磁盘直接使用 RBD,支持快照、克隆 |
| CephFS | POSIX 文件系统接口 | 在 PVE 中可作为共享存储挂载,适合 ISO/模板存放 |
二、工作原理(结合 PVE)
数据写入流程
- VM 在 PVE 上写入磁盘 → 数据通过 RBD 客户端进入 Ceph → 被切分为对象 → 映射到 PG → PG 映射到 OSD → OSD 按 CRUSH 算法决定存放位置。
一致性与冗余
- PVE 配置存储池时可选择副本数或纠删码。
- MON 保证集群状态一致性,OSD 之间自动复制。
扩展性
- 在 PVE 中添加新节点 → 安装 Ceph → 创建 OSD → 自动加入集群。
- CRUSH 算法保证数据自动分布,无需集中目录。
三、PVE 部署要点
- MON 节点:至少 3 个,推荐分布在不同物理机。
- OSD 数量:直接决定容量与性能,建议 NVMe 作为 WAL/DB。
- PG 数量:PVE Web 界面可自动计算推荐值。
- 存储池:在 PVE 中通过 “数据中心 → 存储 → 添加 → RBD” 配置。
- 监控:MGR + Prometheus + Grafana,可在 PVE Web 界面集成。
- NTP:统一NTP服务器,保持时间一致性。
四、典型应用场景
- 虚拟机磁盘:通过 RBD 提供高性能块存储。
- 容器存储:LXC 容器卷直接使用 RBD。
- 共享文件系统:CephFS 用于 ISO、模板、备份。
- 对象存储:RGW 提供 S3 接口,适合备份或应用集成。
PVE系列文章:https://songxwn.com/categories/PVE/
1 | ┌───────────────────────────────┐ |
集群安装Ceph软件
- 确保Apt已经都配置好可用
- 确保至少有三个以上的节点
- 确保有空闲硬盘可用(直通/no-RAID模式)
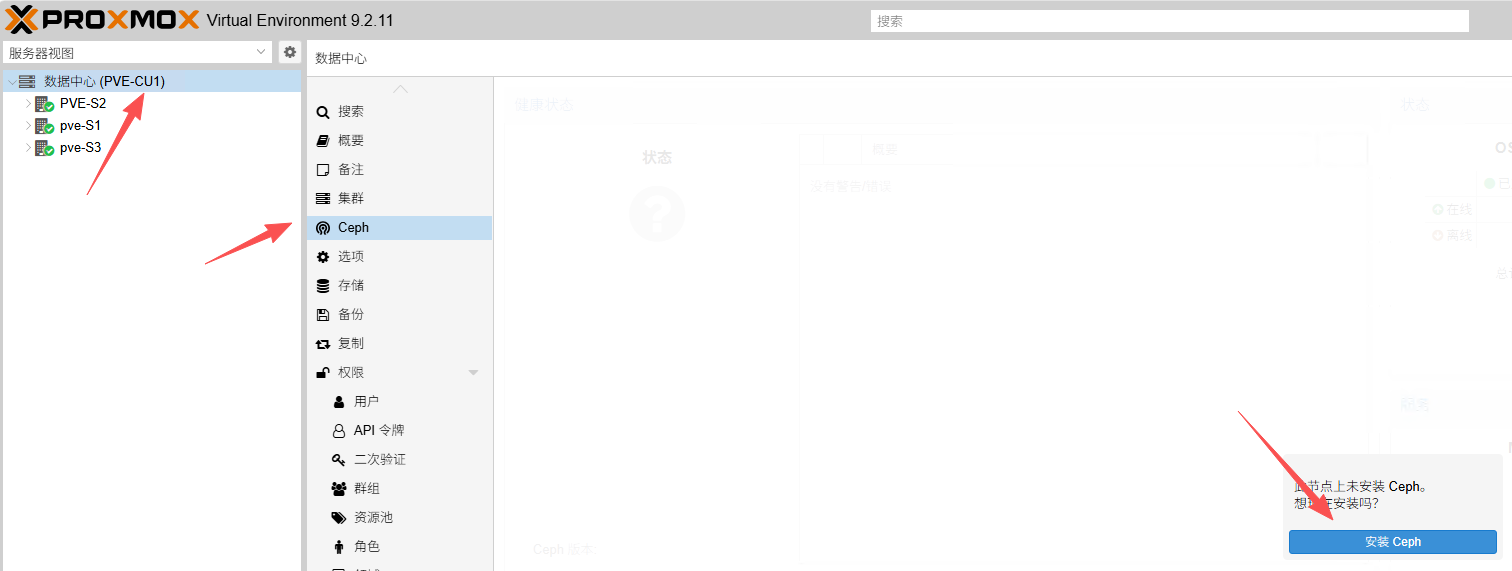
- 第一台PVE安装Ceph软件包 + 集群Ceph初始化
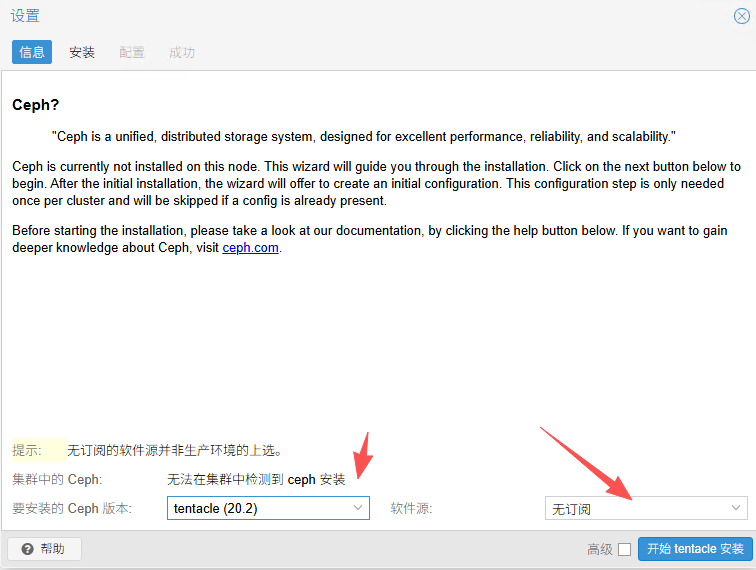
- 选择安装版本(集群要统一版本),选择软件源为无订阅
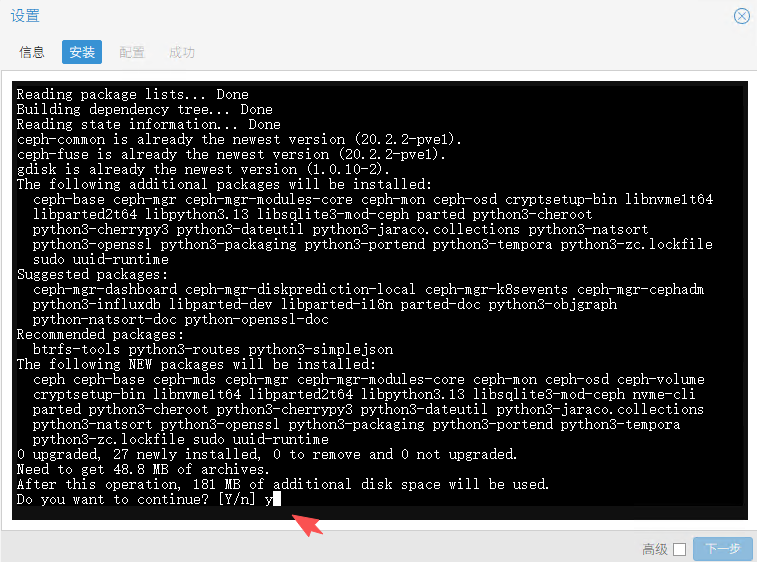
- 输入Y,并回车开始安装。
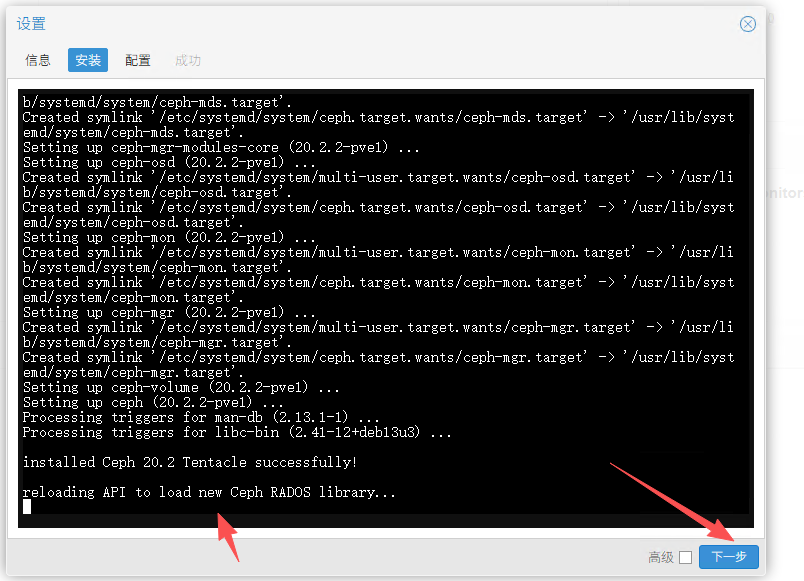
- 安装完成,点击下一步
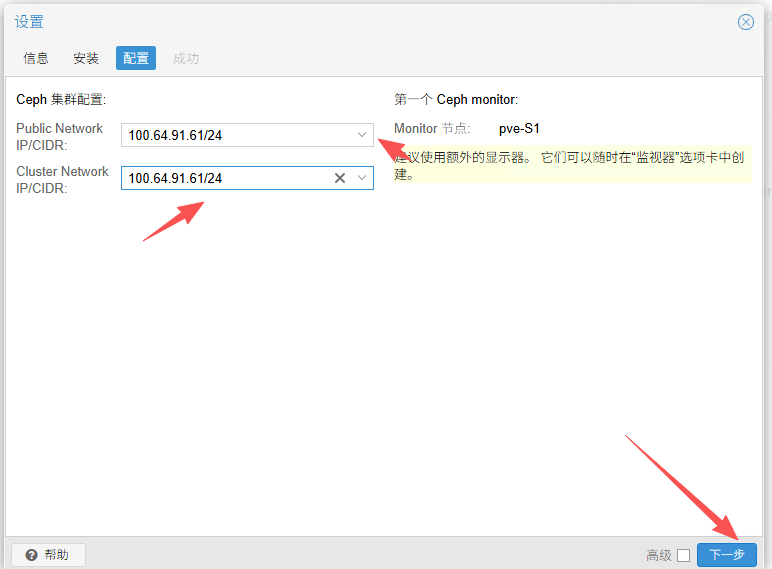
- 配置集群网络
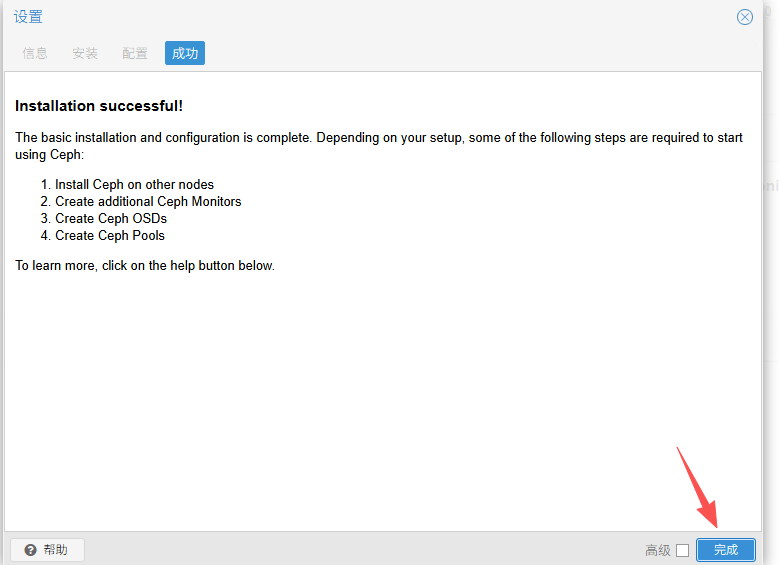
- 安装完成
在每个节点都安装Ceph软件
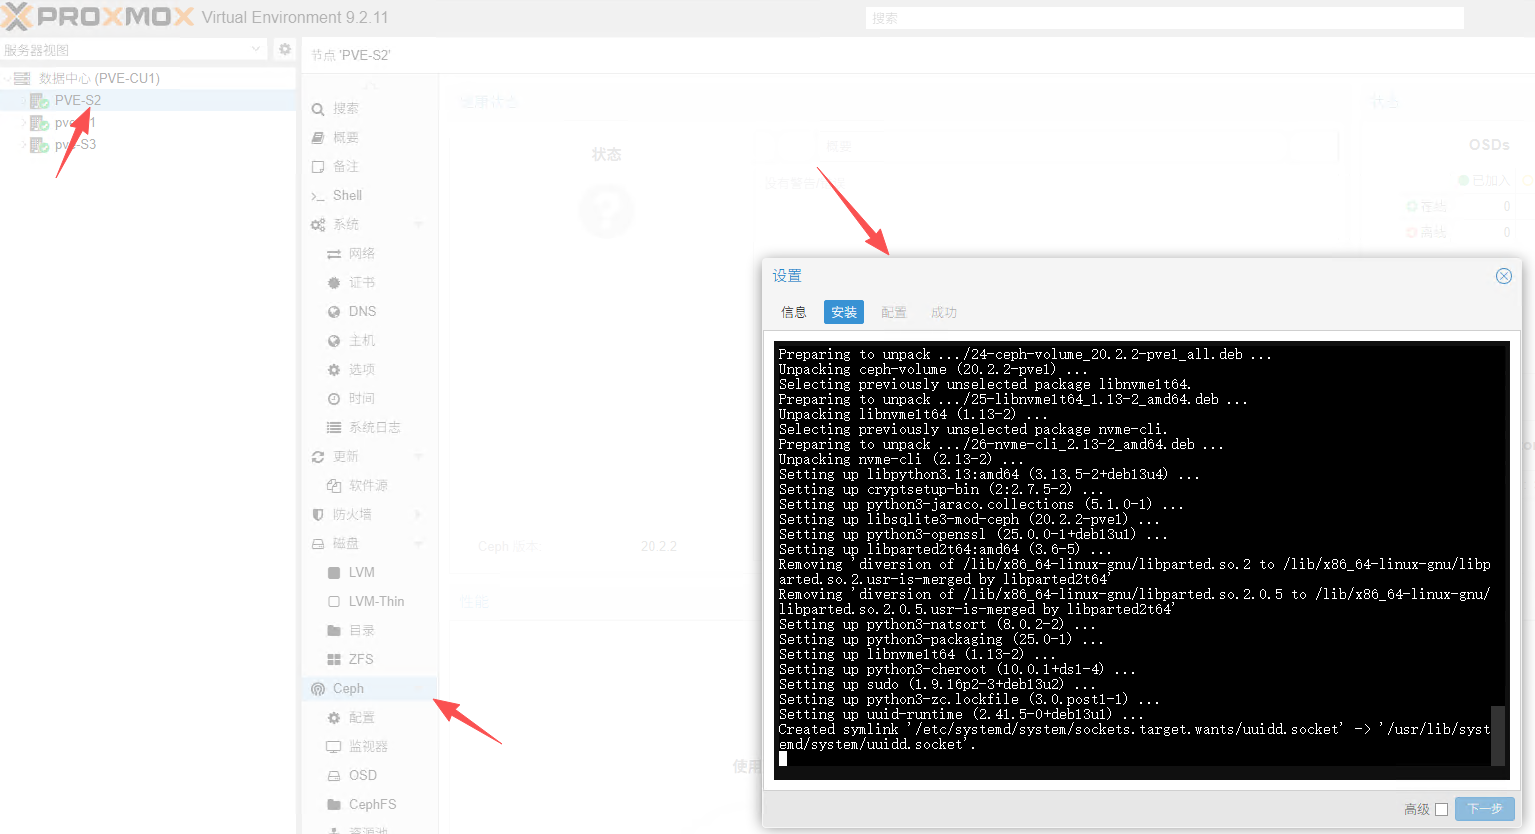
创建OSD
- 去单个节点 - Ceph - OSD - 创建:OSD ,选择裸硬盘
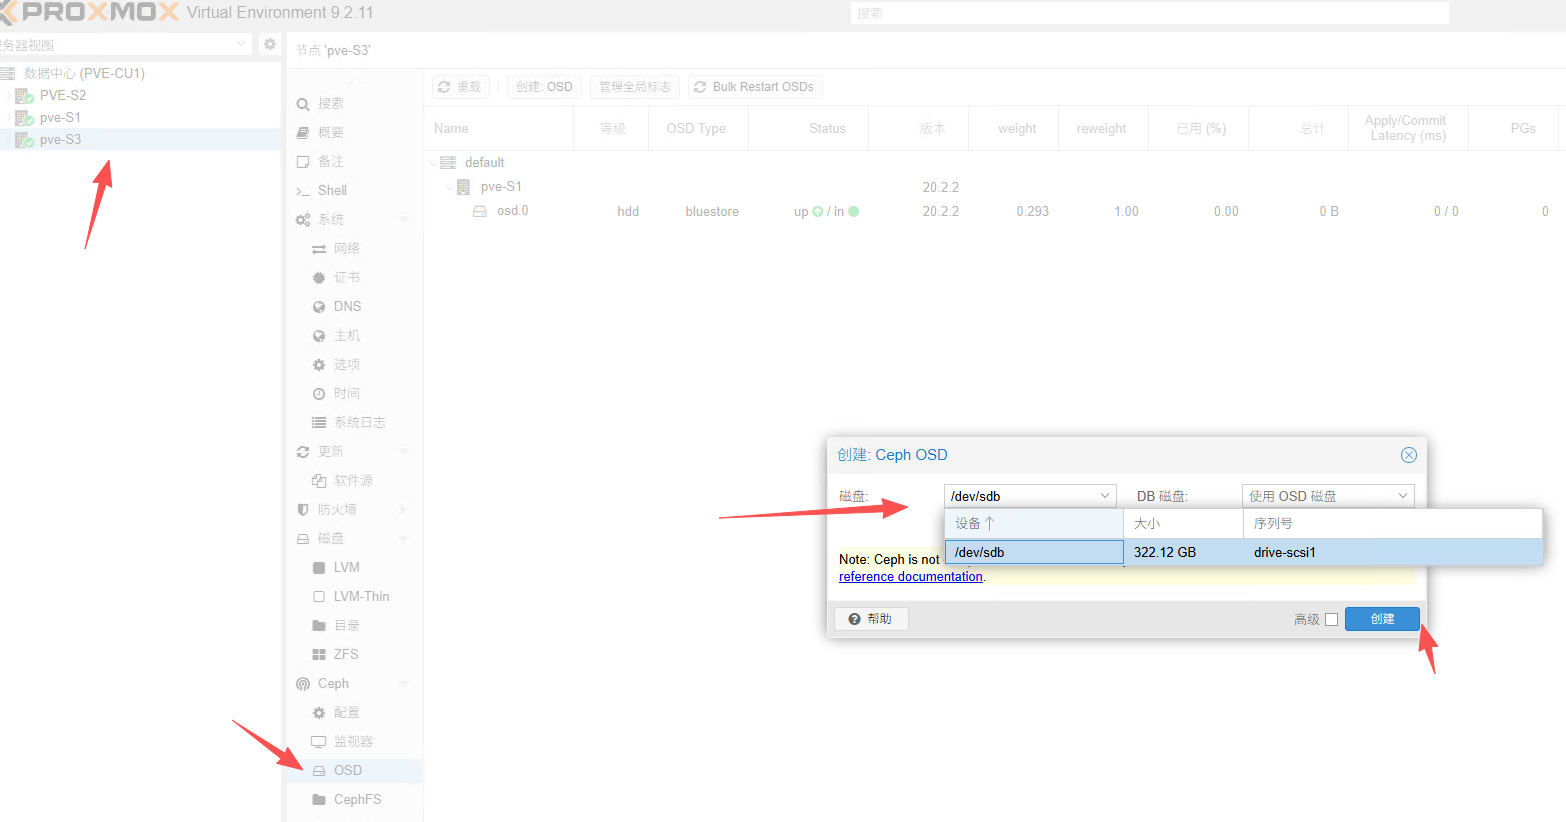
三台节点都创建好OSD
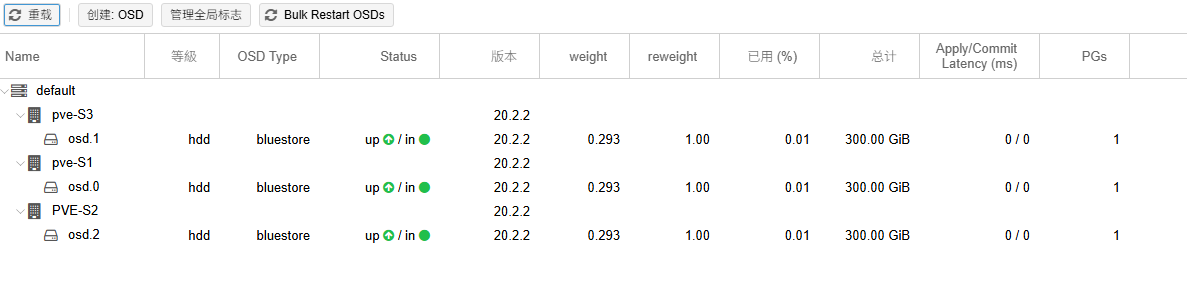
PS:安装完成后会自动有CephRDB,作为块存储,只能存储虚拟机硬盘文件和容器文件。
手动创建RDB
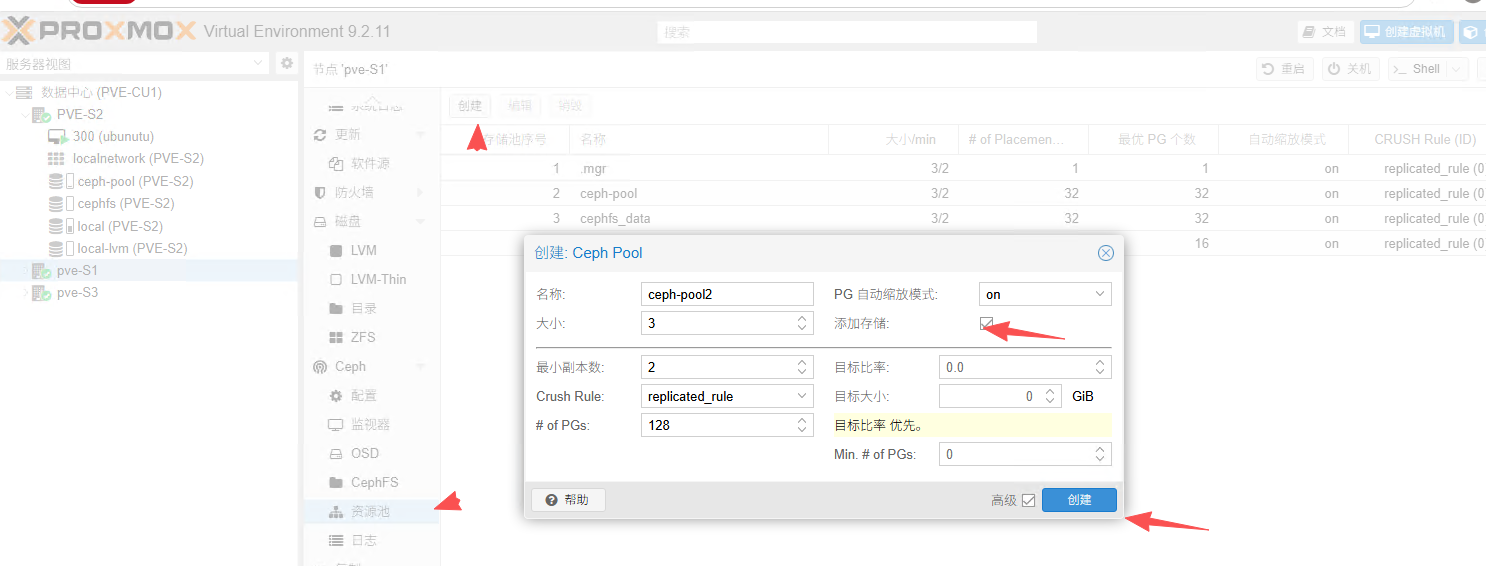
- 在资源池创建RDB Pool,勾选添加存储,会自动挂载到集群,让所有节点可用。
| 参数 | 含义 |
|---|---|
| 名称 (Name) | 池的标识名称,用于在 Ceph 集群中引用该池。 |
| 大小 (Size) | 每个对象的副本数(replication size),例如 3 表示每个对象有 3 份副本。 |
| 最小副本数 (Min. replicas / min_size) | 在允许写入前必须可用的最小副本数;低于此值会阻止写操作以保证一致性。 |
| Crush Rule | 指定 CRUSH 规则(placement rule),决定副本如何在 OSD/主机/机架间分布。 |
| # of PGs (Placement Groups) | 池的 PG 数量,影响数据分布与性能;PG 数量与 OSD 数量应合理匹配。 |
| PG 自动缩放模式 (PG autoscale) | 是否允许 Ceph 自动调整 PG 数量(on/off/warn 等模式)。 |
| 添加存储 (Add Storage) | 代表自动添加到集群存储。 |
| 目标比率 (Target Ratio) | 与自动扩容或配额相关的目标占用比率(界面/实现可能用于自动调整容量)。 |
| 目标大小 (Target Size) | 目标容量大小(例如 GiB),用于容量规划或自动调整策略。 |
| 目标比率 优先 (Target Ratio Priority) | 在自动调整时优先考虑按比率还是按绝对大小进行调整的策略标记。 |
| Min. # of PGs | 自动缩放时允许的最小 PG 数量下限,防止缩得过小影响性能或数据分布。 |
创建Monitors(MON) + Managers (MGR)
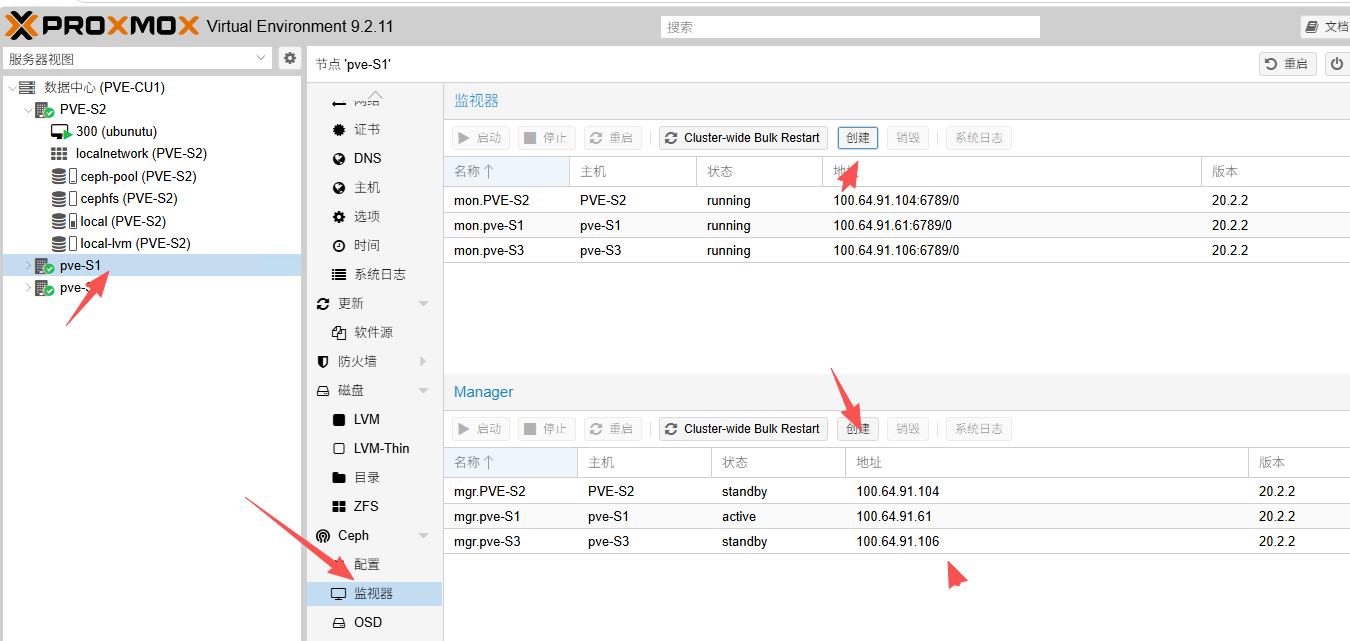
- 单个集群最好有三台以上的MON和MGR用于保持集群冗余性
MDS 和 CephFS
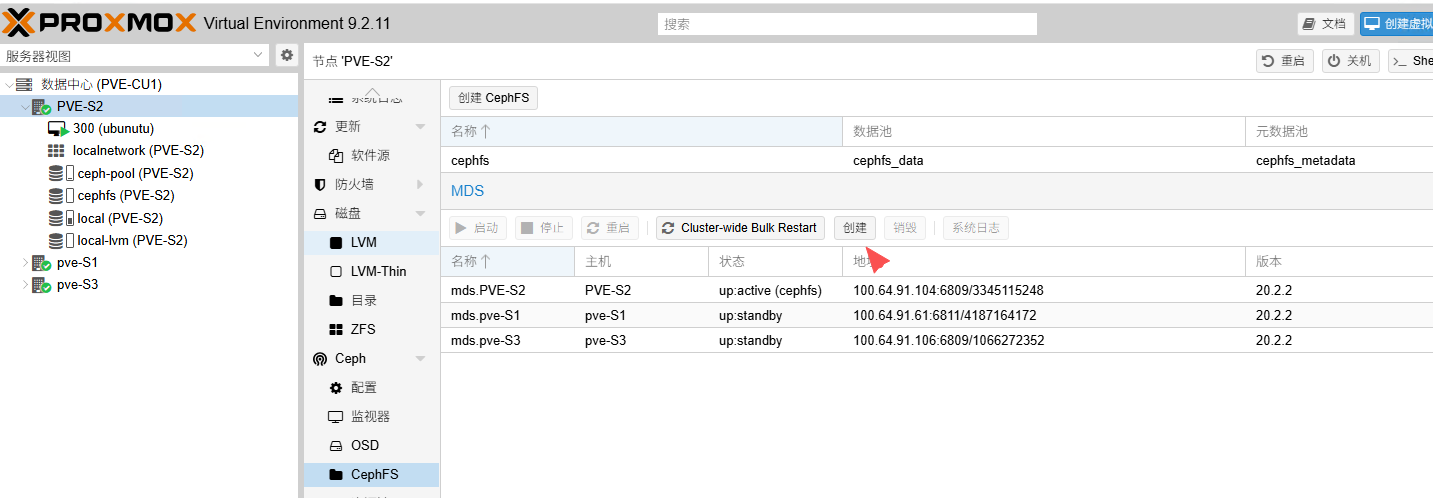
- 必须创建MDS角色才能使用CephFS,也建议默认三个以上保持冗余性。
- CephFS是文件类型的存储,用于存储ISO镜像、虚拟机备份、容器模板等
Ceph PG规划计算器
来自45Drives - https://www.45drives.com/ceph/placement-groups/
虚拟机硬盘镜像对象 - PG - OSD
1 | ceph osd map ceph-pool vm-300-disk-0 |
1 | 对象 vm-300-disk-0 |
对象 → PG:对象名经过哈希函数,落到某个 PG(这里是 pool 2 的 PG 1)。
PG → OSD:PG 再通过 CRUSH 算法映射到一组 OSD,保证分布均衡。
Primary OSD:负责处理客户端请求(读写入口)。
Replica OSD:负责存储副本,保证冗余与高可用。
PS:Ceph默认使用三副本冗余数据,就是将一份数据存放到不同的OSD/节点。
创建FastEC Ceph Pool - 只能在shell下创建
在 Ceph v20 引入的 Fast-EC (Fast Erasure Coding),本质上是对 EC 池 I/O 路径的优化,解决了传统 EC 在小块随机读写场景下的性能瓶颈。默认Ceph 池使用三副本模式,空间利用率低。
Fast-EC 的核心改进
部分读 (Partial Read)
传统 EC 必须读完整条带 (stripe),Fast-EC 允许只读所需部分,减少读放大。部分写 (Partial Write)
过去写入需要完整读-改-写循环,Fast-EC 支持直接写条带的一部分,降低延迟。性能提升
在 RBD、CephFS 小块随机 I/O 场景下,性能提升可达 2–3 倍。RGW 小对象场景也有改善。插件优化
默认 EC 插件由 Jerasure 切换为 Intel ISA-L,利用 CPU 指令集加速编码解码。
启用条件
- 集群版本 ≥ Tentacle (v20)。
- Pool 必须为 EC 类型。
- EC Profile 使用支持的插件组合:
isa+reed_sol_van✅jerasure+reed_sol_van✅
- 条带单元 (stripe unit) 必须是 4096 字节的倍数,推荐 16K。
配置步骤
创建 EC Profile
1
ceph osd erasure-code-profile set fast-ec isa k=4 m=2 crush-failure-domain=host stripe_unit=16K
- K为数据分配数量,M为校验数据数量
创建 Pool
1
ceph osd pool create fast-ec-pool 64 64 erasure fast-ec
启用优化
1
2
ceph osd pool set fast-ec-pool allow_ec_overwrites true
ceph osd pool set fast-ec-pool allow_ec_optimizations true
使用场景
- RBD 虚拟机磁盘:高性能块存储,适合 VM。
- CephFS 文件系统:共享存储,支持小文件高并发。
- RGW 小对象:适合 Iceberg manifest、Parquet footer 等。
风险与限制
- 新特性:Tentacle 才引入,生产环境验证有限。
- 不可逆开关:启用
allow_ec_optimizations后无法回退。 - 条带差异:Fast-EC 默认条带单元为 16 KiB,旧池为 4 KiB,可能影响性能调优。
OSD DB/WAL 组合
在 Ceph 的 OSD 设计里,HDD、SSD、NVMe SSD 的组合方式直接决定了性能、成本和可靠性。在 PVE 部署中常见几种模式:
一、单介质模式
HDD OSD
- 优点:容量大、成本低
- 缺点:IOPS 低、延迟高
- 场景:归档、冷数据池
SSD OSD
- 优点:读写快、适合高并发
- 缺点:容量小、寿命有限
- 场景:热数据池、数据库卷
NVMe OSD
- 优点:极低延迟、高 IOPS
- 缺点:成本高
- 场景:核心业务 VM 磁盘、CephFS 元数据池
二、混合介质模式
- HDD + SSD
- HDD 存放主数据块
- SSD 作为 DB/WAL,提升元数据与日志性能
- 常见配置:
ceph-volume lvm create --data /dev/sdb --block.db /dev/nvme0n1
PS:在PVE Web创建OSD的适合也可以选择DB/WAL设备,若没WAL设备会自动使用DB > 若没DB,则自动使用OSD。所以一般DB选择闪存硬盘就行,WAL会自动使用DB设备。
HDD + NVMe
- HDD 提供容量
- NVMe 作为 DB/WAL,延迟更低
- 适合大规模集群,兼顾容量与性能
SSD + NVMe
- SSD 作为数据盘
- NVMe 作为 DB/WAL
- 适合全闪存集群,进一步降低写放大
三、全闪存模式
全 SSD
- 成本适中,性能较好
- 适合中小规模高性能集群
全 NVMe
- 极致性能,适合金融、AI 训练场景
- 成本最高,需配合高速网络 (≥25Gbps) + RoCEv2
四、组合策略与优化
分层池:
- Hot Pool → SSD/NVMe
- Cold Pool → HDD
- 通过 CRUSH Rule 控制数据分布
副本数调整:
- SSD/NVMe 池可用更高副本数保证可靠性
- HDD 池可用较低副本数节省空间
PG 数量:
- NVMe 池可设置更多 PG,提升并发
- HDD 池 PG 数量适中,避免过载
总结:
- HDD 提供容量,适合冷数据。
- SSD 提供性能,适合热数据。
- NVMe 提供极致低延迟,适合核心业务。
- 最佳实践是 混合部署:HDD 做容量层,SSD/NVMe 做性能层,结合 CRUSH Rule 和 Pool 策略实现分层存储。
1 | ┌───────────────────────────────┐ |
Ceph 使用无损网络 - RoCEv2
在 PVE Ceph 集群中启用 RoCEv2 (RDMA over Converged Ethernet v2),主要是为了降低延迟、提升带宽利用率,让 OSD 间的数据复制和客户端 I/O 更高效。下面分步骤说明:
一、RoCEv2 基础
- RoCEv2:基于 UDP/IP 封装的 RDMA,支持 L3 路由,适合跨交换机部署。
- 优势:低延迟、高吞吐、CPU 占用低,适合 NVMe/SSD OSD 的高并发场景。
- 对比:RoCEv1 仅限二层,RoCEv2 可跨子网,更适合 Ceph 大规模集群。
| 传输方式 | 典型延迟 | CPU占用 | 适用场景 |
|---|---|---|---|
| RoCEv2 | 5–10 µs (单次 I/O) | 极低,数据直达内存 | 高性能存储、NVMe OSD、AI/HPC |
| TCP/IP | 30–80 µs (单次 I/O) | 较高,需内核拷贝 | 通用网络、兼容性强 |
| 本地 NVMe | 70–100 µs | 无网络开销 | 本地盘直连 |
二、网络配置步骤
网卡驱动与固件
- 确认网卡支持 RoCEv2(如 Mellanox ConnectX 系列)。
- 更新固件与驱动,安装 OFED 或内核自带 RDMA 驱动。
启用 RDMA
1
2
3
modprobe rdma_ucm
modprobe ib_core
modprobe mlx5_core验证:
1
rdma link show
配置 RoCEv2
- 打开 PFC (Priority Flow Control) 与 ECN (Explicit Congestion Notification)。
- 在交换机上配置 DCB (Data Center Bridging)。
- 设置 MTU ≥ 9000 (Jumbo Frame)。
绑定 IP 与 RoCEv2
1
2
3
ethtool -i ethX # 查看驱动
rdma link add roce0 type roce netdev ethX
ip addr add 192.168.100.10/24 dev roce0
三、Ceph 配置
OSD 网络参数
在ceph.conf中指定 RDMA 网络:1
2
3
4ms_type = async+rdma
ms_async_rdma_device_name = roce0
ms_async_rdma_port_num = 1
ms_async_rdma_buffer_size = 4096验证 RDMA 通信
1
2
ceph -s
ib_send_bw -d mlx5_0 -i 1确认延迟与带宽符合预期。
四、最佳实践
- HDD Pool:意义不大,瓶颈在磁盘。
- SSD/NVMe Pool:收益明显,适合高性能场景。
总结:在 PVE Ceph 中开启 RoCEv2,需要 硬件支持 + 内核 RDMA 驱动 + 网络交换机配置 + Ceph ms_type=rdma。它主要提升 SSD/NVMe OSD 的性能,对 HDD 池意义有限。
运维技术交流群
发送邮件到 ➡️ me@songxwn.com
或者关注WX公众号:网工格物